- Published on
서버 한 대가 죽거나 배포할 때, 서비스는 멈추지 않나
- Authors

- Name
- 김민석
서버가 한 대면 배포할 때마다 서비스가 멈춘다
서버 한 대에 앱 하나를 띄워 두고 프로세스를 껐다 켜서 배포하던 구성이었다. 두 가지가 걸렸다.
배포하는 동안 요청을 받을 프로세스가 없다. 재시작에 걸리는 시간만큼 서비스가 끊긴다.
그리고 그 서버가 죽으면 서비스 전체가 죽는다. 장애 지점이 하나다.
여기서 시작해 이중화, 무중단 배포, 롤백, 그리고 서버가 2대가 되면서 새로 생긴 문제까지 순서대로 고쳤다.
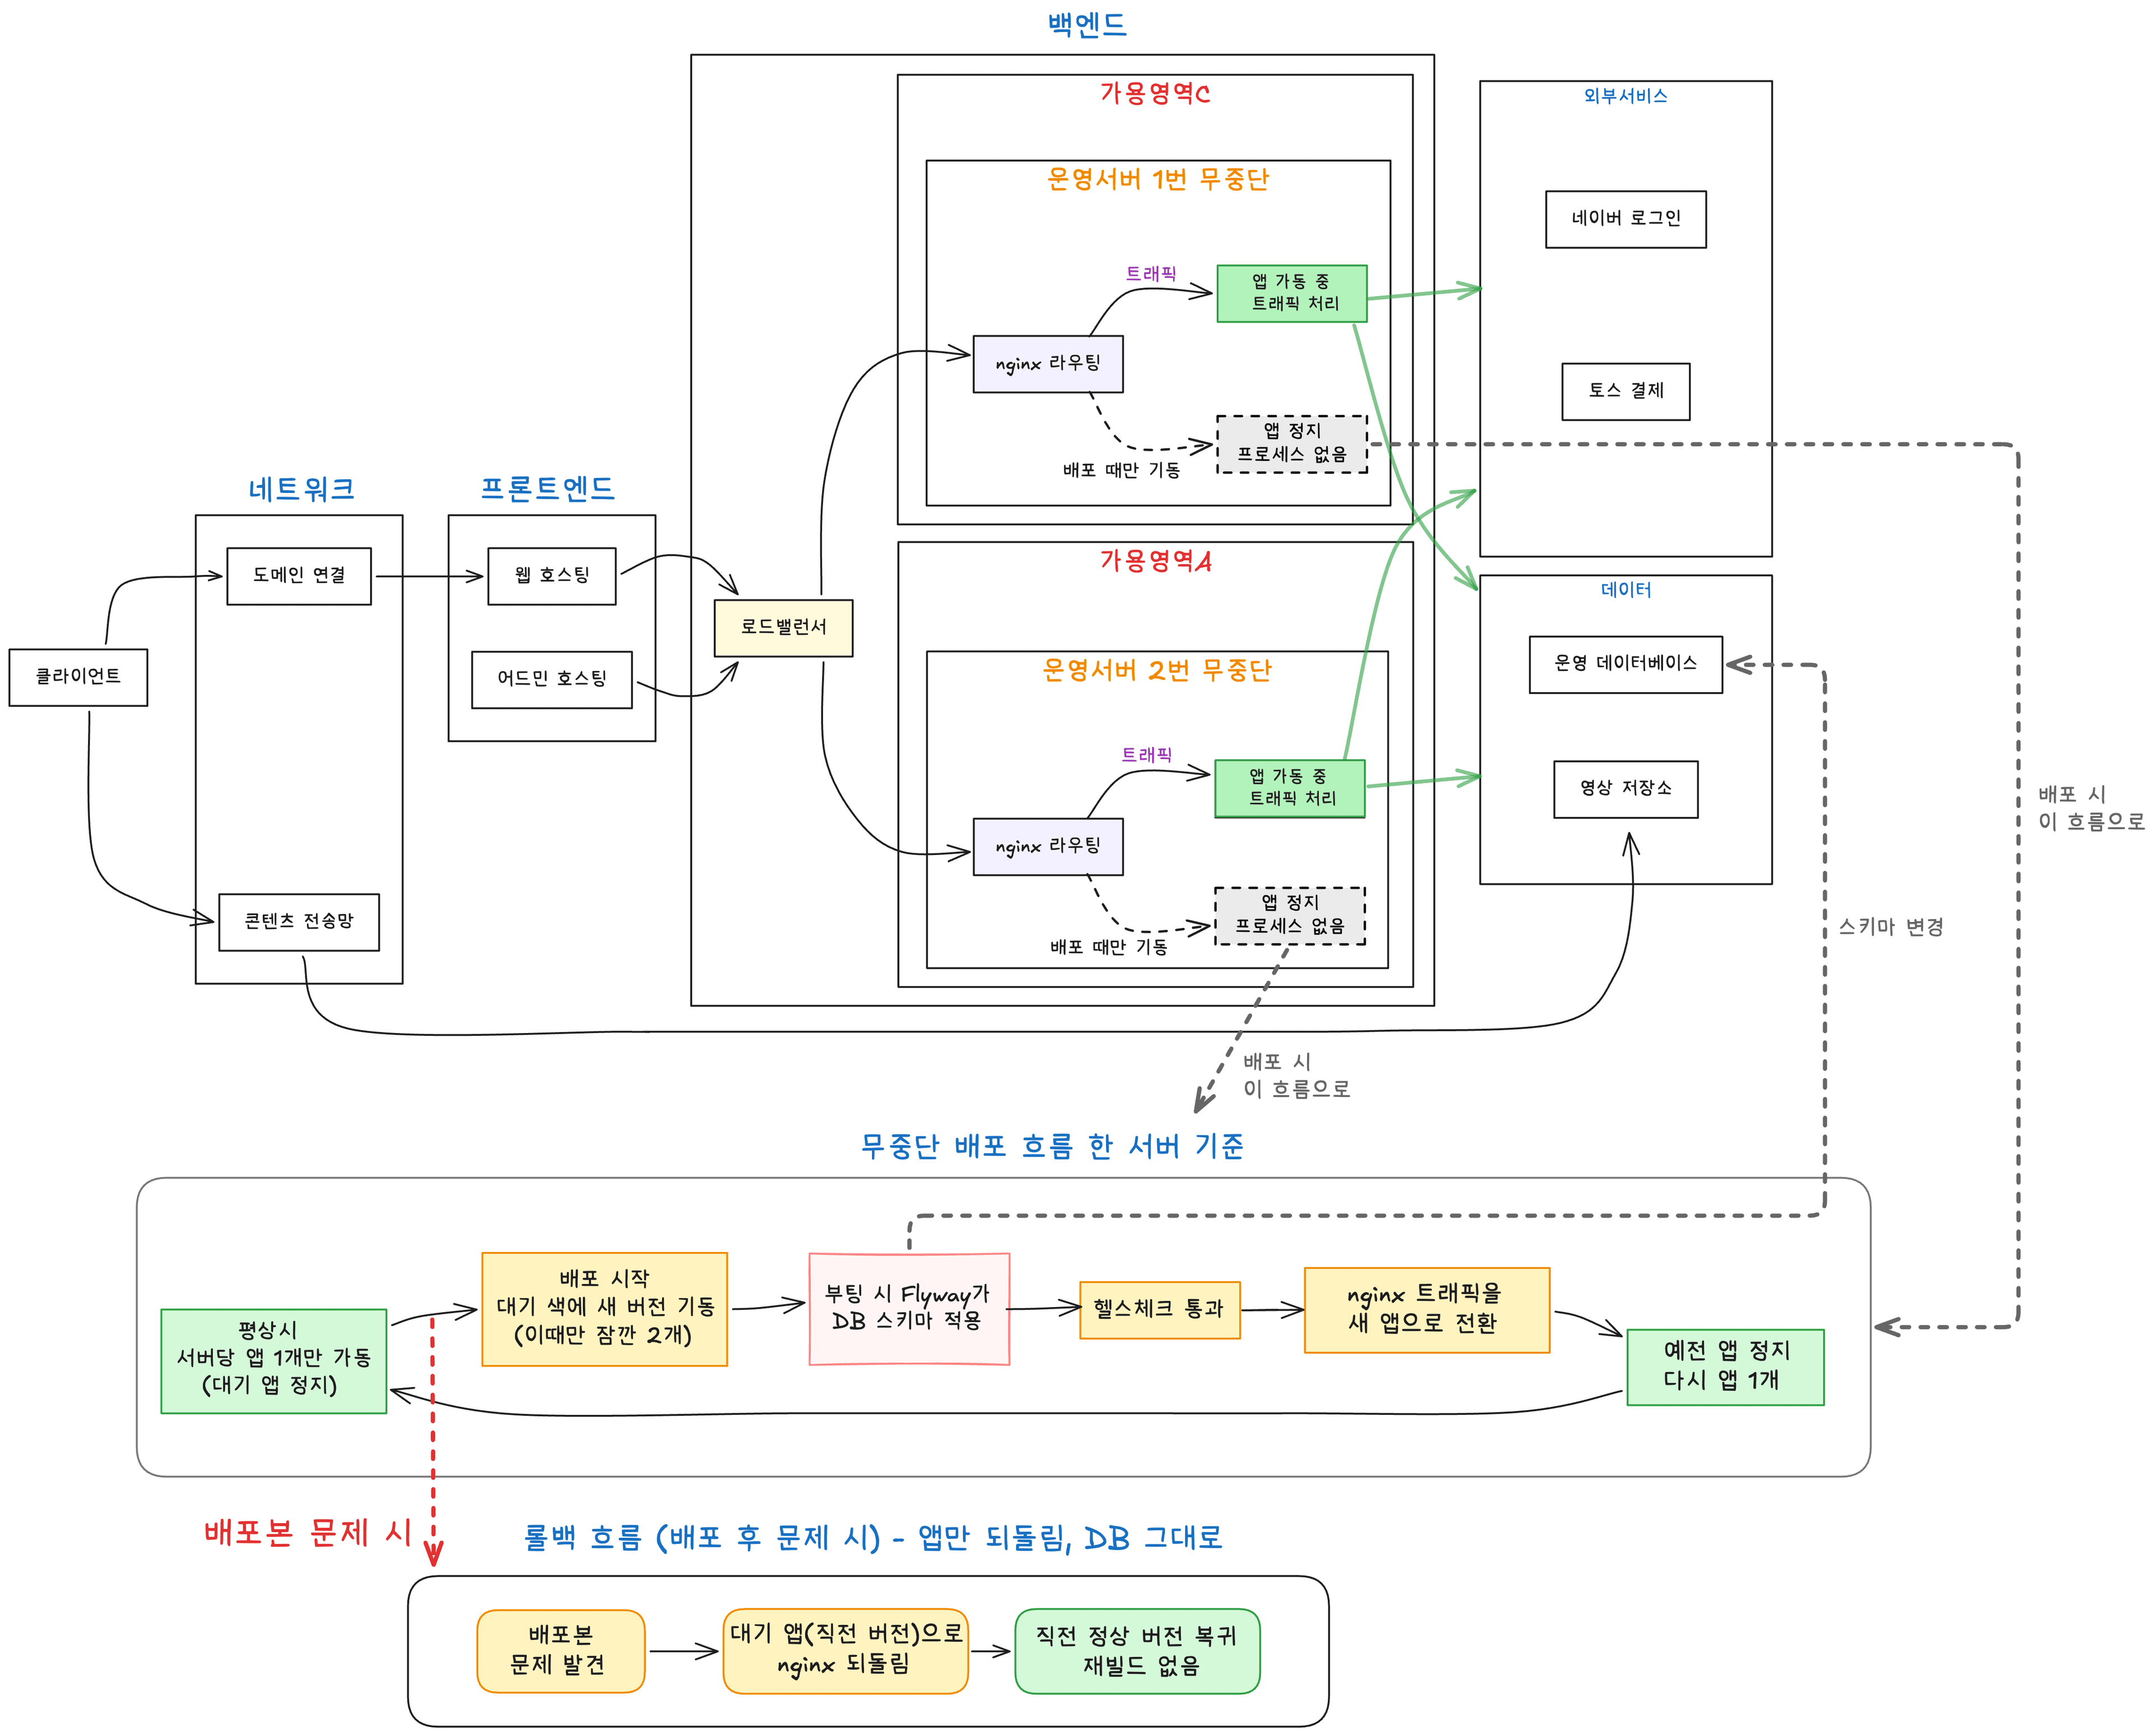
그림을 읽는 법은 이렇다.
- 위쪽
백엔드상자 안에 가용 영역이2곳있고, 영역마다 운영 서버가1대씩 있다. 서버마다앱 가동 중과앱 정지2칸이 있는데, 정지 칸은 배포할 때만 잠깐 기동한다 - 아래쪽
무중단 배포 흐름이 그 정지 칸을 쓰는 순서다. 새 버전 기동 →Flyway가 DB 스키마 적용 → 헬스체크 →nginx전환 → 예전 앱 정지 - 맨 아래
롤백 흐름은 앱만 되돌리고 DB는 그대로 둔다
가용 영역을 나눠 서버를 2대로 늘렸다
운영 서버를 2대로 늘리고 서로 다른 가용 영역에 뒀다. 한 영역에 장애가 나도 다른 영역의 서버가 요청을 이어받는다.
앞단에는 로드밸런서를 뒀다. 들어온 요청을 2대에 나눠 보내고, 헬스체크에 실패한 서버는 자동으로 대상에서 뺀다. 뺀 서버가 헬스체크를 다시 통과하면 자동으로 다시 넣는다.
로드밸런서는 80으로 들어온 요청을 443으로 돌린다. 외부에서 어떤 방식으로 접속해도 보안 연결로 바뀐다. 내부 구간에서는 80으로 각 서버의 nginx에 전달하면서, 원래 HTTPS였다는 표시를 같이 넘긴다. 이 표시가 없으면 로그인 리다이렉트가 http로 만들어져 깨진다.
앱 프로세스가 죽는 경우와 서버가 죽는 경우는 복구 경로가 다르다.
- 앱 프로세스가 죽으면
systemd가 자동으로 다시 띄운다. 메모리 부족으로 JVM이 종료돼도 같은 경로를 탄다 - 서버가 재부팅되면 활성 앱만 자동 기동된다. 배포할 때 새 앱만 자동 기동 대상으로 등록하고 예전 앱은 해제해 두기 때문이다
- 인스턴스 자체가 죽으면
systemd도 같이 죽는다. 상태 검사 실패 경보 메일을 받고 사람이 복구한다
서버를 늘려도 배포 중 끊김은 그대로다
서버가 2대여도 프로세스를 껐다 켜는 방식이면 재시작하는 서버는 여전히 요청을 못 받는다.
배포 방식 세 가지를 놓고 골랐다.
- 롤링은 한 대씩 빼고 교체하는 방법인데, 서버가
2대라 교체하는 동안 한 대로만 서비스한다. 롤백도 예전 버전을 다시 빌드해 배포해야 한다 - 카나리는 일부 요청만 새 버전으로 보내고 지표를 보며 비율을 늘리는 방법인데, 무엇을 보고 늘릴지 정할 에러율과 응답 시간 기준이 없다
- 블루그린은 서버를 늘리지 않고 한 서버 안에 앱 슬롯을
2개두는 방법이다. 예비 슬롯에 새 버전을 먼저 띄워 두고 전환한다
블루그린으로 갔다. 서버를 더 쓰지 않고, 예전 버전이 슬롯에 그대로 남아 롤백이 재빌드 없이 된다.
한 서버 안에 슬롯 2개를 두고 1개만 켜 둔다
한 서버에 systemd 서비스를 2개 등록했다. bootscat-blue가 8080, bootscat-green이 8081이다. 둘은 같은 앱이고 포트만 다르다.
컨테이너가 아니다. 이미지 레지스트리도 오케스트레이터도 두지 않고 systemd가 jar를 직접 실행한다. 서버 한 대 규모에 컨테이너 런타임을 얹을 이유가 없었다. 그래서 정지 단위도 컨테이너가 아니라 프로세스다.
평상시에는 한 슬롯만 켜져 있다. 트래픽만 안 받는 상태가 아니라 아예 꺼져 있다. 서버당 상시 비용은 앱 1개분이다. 2개 슬롯이 같이 떠 있는 것은 배포하는 순간뿐이다.
외부에 열린 통로는 nginx의 80 하나다. 앱 포트 8080과 8081은 보안 그룹에 열려 있지 않아 서버 밖에서 닿지 않는다. 지금 어느 슬롯이 활성인지는 nginx 설정이 정한다.
jar는 색깔별 고정 경로 2개를 덮어쓴다. 배포를 반복해도 파일이 쌓이지 않고, 각 색에는 항상 마지막으로 그 색에 배포한 버전 하나만 있다.
배포는 한 대가 끝나야 다음 한 대로 간다
main에 머지되면 빌드가 돌고, 운영 서버 1번을 먼저 전환한다. 성공해야 2번으로 간다. 한 번에 한 대씩이라 배포하는 내내 최소 한 대는 요청을 받는다.
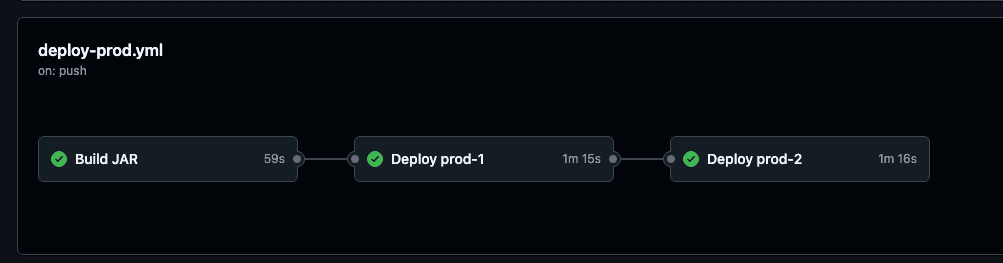
- 빌드가 끝나야
prod-1이 시작하고,prod-1이 끝나야prod-2가 시작한다. 두 서버가 같이 배포되지 않는다 - 빌드
59초, 서버당1분 15초로 배포 전체가3분 30초다
한 대 안에서의 순서는 맨 위 그림의 무중단 배포 흐름과 같다.
- 꺼져 있던 슬롯에 새 버전을 기동한다
- 부팅하면서
Flyway가 대기 중인 DB 마이그레이션을 먼저 적용한다 - 헬스체크를 통과하면
nginx가 가리키는 포트를 새 슬롯으로 바꾼다 - 예전 슬롯의 프로세스를 정지한다.
jar는 지우지 않는다
헬스체크를 통과하지 못하면 nginx를 건드리지 않는다. 배포가 실패해도 예전 버전이 계속 요청을 받는다.
Flyway를 헬스체크 앞에 둔 것은 코드와 스키마가 같이 배포되게 하려는 것이다. 운영은 ddl-auto=validate라 코드가 기대하는 스키마와 실제 스키마가 어긋나면 앱이 부팅하지 못한다. 스키마만 뒤처진 상태로 앱이 뜨는 일이 없다.
되돌릴 때는 다시 빌드하지 않는다
배포하고 나서 문제를 발견하면 코드를 급히 고치는 대신 직전 버전으로 되돌린다.
무중단 배포가 예전 앱을 정지만 하고 jar는 남겨 두기 때문에, 꺼져 있는 슬롯에 직전 버전이 그대로 있다. 되돌리는 것은 그 슬롯을 다시 기동하고 nginx 전환을 되돌리는 일이다. 빌드도 배포도 다시 하지 않는다.
rollback-prod.yml을 수동 실행하고 사유를 적으면 운영 서버 1번, 2번 순서로 직전 색으로 넘어간다. 롤백도 반대 색으로 넘기는 것이라, 한 번 더 실행하면 최신 버전으로 돌아온다. 최신 jar가 그때는 꺼진 슬롯에 남아 있다.
직전 버전이 헬스체크를 통과하지 못하면 전환하지 않고 현재 버전을 유지한다. 롤백이 실패해도 서비스는 끊기지 않는다.
맨 위 그림 아래쪽 롤백 흐름이 이 순서다. 되돌아가는 것은 앱뿐이다.
| 대상 | 롤백 |
|---|---|
| 앱 | 직전 버전으로 되돌아감 |
| DB, 데이터 | 그대로 유지 |
그래서 새 배포가 스키마를 바꿨다면 예전 버전 앱과 새 스키마가 어긋날 수 있다. 마이그레이션을 하위호환으로 쓰는 이유다. 컬럼을 지우거나 이름을 바꾸는 대신 더하는 쪽으로 쓴다. 어긋나서 부팅에 실패하면 위의 자동 보호가 걸려 현재 버전이 유지된다.
배포 도구가 상시 열쇠를 들고 있지 않다
배포에는 AWS 권한과 서버 접속이 둘 다 필요하다. 둘 다 평소에는 없고 배포하는 순간에만 받는다.
AWS 권한은 OIDC로 받는다. 저장소에 장기 액세스 키를 넣어 두지 않고, 깃허브 액션이 발급한 토큰으로 그 실행에만 유효한 임시 자격 증명을 받는다. 어느 저장소와 어느 브랜치에서 온 요청인지까지 조건으로 걸어 둬서, 다른 저장소가 같은 역할을 맡을 수 없다. 운영용 역할과 테스트용 역할은 분리돼 있다.
서버 접속은 배포가 시작될 때 러너의 IP만 22번에 잠깐 열고, 끝나면 그 규칙을 지운다. 상시 열린 포트가 없다.
서버가 저장소에 접근할 때도 마찬가지다. 서버 안에 키를 두지 않고 인스턴스에 부여된 역할로 접근한다. 인스턴스 메타데이터 조회는 토큰을 요구하는 방식으로 강제해 뒀다.
서버가 2대가 되자 배치가 두 번씩 돌았다
이중화의 대가가 여기서 나왔다. @Scheduled는 프로세스마다 실행된다. 서버가 2대가 되면서 구독 갱신, 만료 처리, PG 양방향 대조가 매일 두 번씩 돌았다. 갱신이 겹치면 같은 구독에 결제가 두 번 나갈 수 있다.
분산 락이 필요했다. Redis를 새로 띄우는 방법은 고르지 않았다. 락 하나를 위해 운영할 대상이 하나 더 늘어난다.
이미 쓰고 있는 MySQL에 ShedLock을 붙였다. 배치가 시작할 때 테이블 한 행을 잡고, 잡은 프로세스만 실행한다. 못 잡은 쪽은 그 회차를 건너뛴다.
두 가지를 따로 정했다.
- 락 만료 판정은 서버 시계가 아니라 DB 시간으로 한다. 두 서버의 시계가 조금 달라도 같은 기준으로 판정된다
- 프로세스가 락을 쥔 채로 죽으면 그 락이 영구히 남는다.
lockAtMostFor로 최대 보유 시간을 정해 그 시간이 지나면 풀리게 했다
락이 못 하는 일이 하나 있다. 락은 중복 실행만 막고 실행 자체를 보장하지 않는다. 두 프로세스가 다 죽어 있으면 그날 배치는 아무도 돌지 않는데, 락 입장에서는 정상이다. 그래서 배치마다 시작, 성공, 실패를 DB에 기록해 안 돌았거나 도중에 끊긴 회차를 추적한다.
화면과 영상은 콘텐츠 전송망이 내보낸다
사용자 요청은 도메인에서 콘텐츠 전송망으로 들어온다. 화면은 콘텐츠 전송망이 호스팅하고, API 요청만 로드밸런서로 간다.
영상은 업로드된 원본이 입력 저장소에 들어가고, 변환 서비스가 스트리밍용 HLS로 바꿔 출력 저장소에 넣는다. 사용자에게는 콘텐츠 전송망의 서명 주소로만 제공한다. 계정 수준에서 모든 퍼블릭 액세스를 차단해 둬서 저장소 주소를 알아도 직접 받을 수 없다.
데이터베이스와 서버에는 외부에서 직접 닿지 못한다
운영 MySQL은 다중 가용 영역으로 복제해 두고 자동 백업을 7일 보관한다. 퍼블릭 액세스는 꺼져 있어 같은 내부 네트워크의 서버만 접근한다.
운영 서버 보안 그룹의 인바운드 규칙은 2개뿐이다. 80은 로드밸런서 보안 그룹에서 오는 요청만 받고, 22는 정해진 대역에서만 받는다. 모든 곳에서 접근할 수 있게 열린 규칙이 없다.
로드밸런서만 80과 443을 외부에서 받는다. 사용자의 첫 접점이라 그래야 한다.
경보 14개로 알게 한다
임계치를 넘으면 메일을 받는다.
| 종류 | 개수 | 내용 |
|---|---|---|
| OS | 8개 | 메모리, 디스크, CPU, 상태 검사 실패를 운영 서버 2대에 각각 |
| JVM 힙 | 2개 | 서버별 힙 사용량 |
| DB 커넥션 풀 | 4개 | 대기 커넥션 |
남은 것
- 지표 기반 자동 롤백. 지금은 배포 실패만 자동으로 막고, 배포는 됐는데 에러율이 오르는 경우는 사람이 보고 롤백한다
- 인스턴스 장애 시 자동 복구. 지금은 경보 메일을 받고 사람이 복구한다
정리
| 문제 | 고친 것 | 결과 |
|---|---|---|
| 서버 한 대라 장애 지점이 하나 | 가용 영역 2곳에 서버 2대, 로드밸런서 헬스체크 | 한 대가 빠져도 서비스 유지, 실패한 서버는 자동 제외와 자동 편입 |
| 배포하는 동안 요청 받을 프로세스가 없음 | 한 서버에 슬롯 2개를 두는 블루그린, 한 대씩 순차 전환 | 배포 중에도 최소 한 대는 요청을 받음 |
| 되돌리려면 재빌드와 재배포 | 예전 jar를 슬롯에 남기고 nginx 전환만 되돌림 | 재빌드 없이 직전 버전 복귀, 실패하면 현재 버전 유지 |
| 서버 2대가 되자 배치가 두 번씩 실행 | MySQL 행 잠금 방식 ShedLock, 배치 상태를 DB에 기록 | 한 프로세스만 실행, 미실행과 중단도 추적 |